Crawl & indexation
Explorée, actuellement non indexée. Comme mes week-ends.
Environ 58 résultats (0,22 seconde)
Commandable maintenant (70) Le catalogue ouvre par vagues : tout est en ligne, une partie se commande déjà.

noindex, nofollow : introverti

Bloqué par robots.txt

Il existe : c’est dans les logs

Un seul Père Noël est canonique

Bouchon entre publication et indexation

Contenu derrière un digicode

Exclue par la balise « mariage »

La sardine qui a bouché le port 443

Le robots.txt d’un Parisien

Page orpheline : la calanque de /tarifs

Paris ne s’est pas indexé en un jour

robots.txt marseillais : User-agent Parisien

Budget crawl 2 %

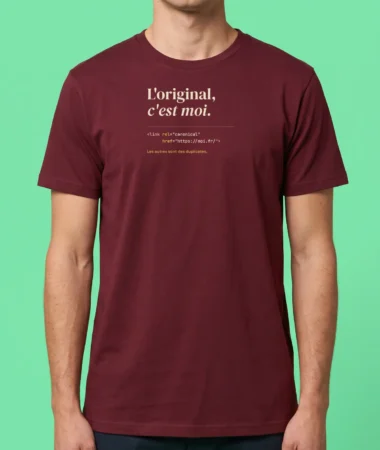
L'original, c'est moi

Sitemap du vendredi

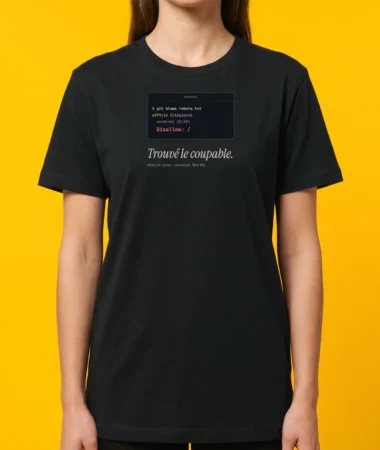
git blame robots.txt

x-robots-tag: noindex

Ça marche !

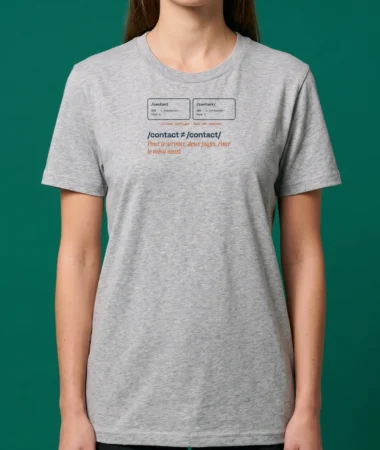
/contact ≠ /contact/

Mémoire insuffisante

Limite : 500 URL

Export : 2 millions de lignes

Crawl de nuit
La page 2 de Google est le meilleur endroit pour cacher un cadavre. Ici, c'est là que sont les pépites.
Le robot passe, ou ne passe pas. Il lit le robots.txt, suit le sitemap, explore, puis décide seul de ce qui entre dans l'index. Ces t-shirts, mugs et posters sont pour ceux qui savent ce que veut dire « explorée, actuellement non indexée ».